Resumen: una base SQL Server y una PostgreSQL se respaldan en un recurso local y en un bucket de almacenamiento de objetos con Object Lock. Un ransomware simulado elimina ambas bases, borra el recurso y usa la clave de copias robada contra el bucket; luego ambas bases se restauran solo desde la copia inmutable en hosts limpios, se verifican, y el RPO y el RTO logrados se miden frente a objetivos escritos. Un runbook y un ejercicio de mesa lo completan. Todo se ejecuta en GitHub Actions contra contenedores. Las ejecuciones de CI son reales; los datos son sintéticos.
| Rol | Ingeniero de bases de datos / seguridad responsable de que las bases de una pequeña clínica se puedan recuperar |
| Entorno | Repositorio público de GitHub, runners Ubuntu de GitHub, contenedores de SQL Server 2025 y PostgreSQL 18, MinIO (compilación de Chainguard) |
| Herramientas | Python 3.12, boto3, copias nativas de SQL Server, pg_basebackup + archivado de WAL, sqlcmd, pg_amcheck, pytest, ruff, mypy, shellcheck, gitleaks |
| Entregable | Herramienta de envío de copias y restauración (drkit), simulacro de ransomware, RPO/RTO medidos con compuerta, runbook de recuperación y ejercicio de mesa (EN/ES), CI, ruleset de rama, PR de demostración |
1. Problema
Los operadores de ransomware van primero por las copias de seguridad: una copia que los servidores comprometidos alcanzan, o que las credenciales de copias robadas pueden borrar, ya no está cuando se necesita. "Tenemos copias" no es un plan de recuperación; un plan de recuperación dice cuántos datos y cuánto tiempo puede perder el negocio, mantiene al menos una copia que el atacante no puede destruir y demuestra — con regularidad y con números — que las bases vuelven dentro de esos límites.
2. Diseño
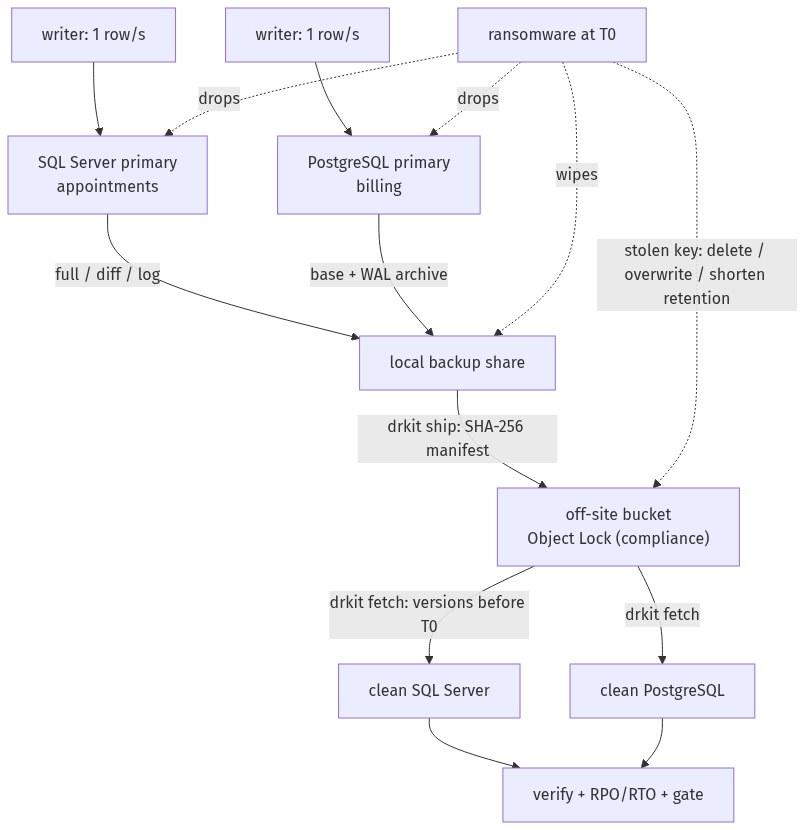
- Dos niveles. Las copias nativas llegan a un recurso local (rápido para restaurar, pero alcanzable). Cada archivo terminado se envía a un bucket externo con Object Lock en modo compliance: hasta la fecha de retención nadie puede borrar una versión bloqueada ni acortar su retención — ni la clave de copias ni un administrador.
- La clave no es la protección. La clave de escritura de copias tiene permiso para borrar objetos y versiones. Si el borrado solo lo impidieran los permisos, quien robara una clave con más privilegios podría hacerlo igual; el bloqueo no depende de quién lo pida.
- Manifiesto con versiones. Cada archivo enviado queda registrado con su versión de objeto y su SHA-256; el manifiesto también se envía y se bloquea. La recuperación descarga cada archivo por versión, así que una sobrescritura del atacante (una versión más nueva) o un marcador de borrado no cambian nada.
- El último punto seguro. La recuperación solo lee versiones de objetos que el almacenamiento escribió antes de T0, el inicio del ataque. Todo lo posterior puede ser del atacante.
- Tiempo comprimido. El calendario corre a un minuto de política por segundo real. El RPO, que depende del intervalo de copias, se mide en segundos reales y se convierte a minutos de política para compararlo; el RTO, que depende del trabajo de restauración, no se comprime.
3. El simulacro
- Dos primarios con un escritor cada uno (una fila por segundo: la referencia para medir la pérdida de datos).
- SQL Server: copia completa en el minuto de política 0, copias de log cada 15 y una diferencial en el 360.
PostgreSQL: una copia base y archivado continuo de WAL.
drkit shipcopia cada archivo terminado al bucket. - En T0 (minuto de política 400) el ransomware detiene el agente de copias, elimina ambas bases, borra el recurso local y, con la clave robada, intenta sobre cada versión de objeto: acortar la retención, borrar la versión, sobrescribir y borrar.
drkit fetcharma cada cadena de restauración solo desde el bucket — la completa más reciente, la diferencial posterior más reciente y cada log posterior (si falta un número de log, es un error); la copia base y el WAL contiguo desde su segmento inicial (si falta un segmento, es un error) —, descarga por id de versión y comprueba cada SHA-256.- Restauraciones en contenedores limpios, luego
DBCC CHECKDB/pg_amchecky una comprobación de que las filas restauradas son contiguas.
4. Medición
- RPO logrado = T0 − la fila más reciente de la base restaurada: los datos realmente perdidos, leídos de los datos.
- RTO logrado = desde "recuperación declarada" hasta "restauración verificada", tiempo de reloj.
- Compuerta: falla si se incumple un objetivo, si una restauración no se verifica o si se pierde cualquier versión original en el nivel externo.
5. Runbook y ejercicio de mesa
El runbook (docs/runbook.es.md) define los roles, cuatro puntos de decisión — ¿los datos son confiables?,
¿restaurar en el sitio o en hosts limpios?, ¿cuál es el último punto de restauración seguro?, ¿cuándo volver al
servicio? — y los procedimientos por motor con los comandos que ejecuta el simulacro, así que CI ejercita el runbook
en cada ejecución. El ejercicio de mesa (docs/tabletop-ransomware.es.md) es un ejercicio escrito con eventos
cronometrados (el recurso de copias también cifrado, extorsión, presión para restaurar la copia más reciente) y las
decisiones esperadas; no se ha realizado con personas.
6. Pipeline
| Job | Qué prueba |
|---|---|
lint |
ruff, mypy (estricto), shellcheck |
unit |
los módulos puros con fixtures y un almacenamiento versionado falso con Object Lock: huecos en la cadena, diferencial obsoleta, versiones posteriores a T0, checksum que no coincide, ataque y supervivencia, límites de RPO/RTO, escapado del reporte; umbral de cobertura del 90 % |
drill |
el ciclo completo en ambos motores; artefactos: reporte, registro del ataque, manifiestos, cadenas de restauración, tiempos |
secrets |
gitleaks sobre todo el historial |
Se ejecuta en cada pull request, en los push a main, cada semana y a demanda. Un ruleset en main exige pull
request y los cuatro jobs.
7. Resultados
De la ejecución 37044822230 en main
(2026-10-02, código final); docs/example-report.html es su reporte. La primera ejecución en verde,
37043674073, dio el mismo resultado
(appointments RPO 11,1 min, RTO 2,1 s; billing RPO 1,8 min, RTO 59,7 s; 0 versiones perdidas). Tras las
correcciones de la revisión final, la ejecución 37049627002
pasó las nuevas comprobaciones — ninguna petición destructiva aceptada, la reproducción de PostgreSQL llegó al último
segmento de WAL obtenido — con el mismo panorama (appointments RPO 11,0 min, RTO 2,5 s; billing RPO 2,4 min,
RTO 39,8 s; 0 versiones perdidas).
| Sistema | Objetivo RPO | RPO logrado | Objetivo RTO | RTO logrado | Verificado |
|---|---|---|---|---|---|
appointments (SQL Server) |
≤ 15 min | 10,5 min (10,5 s reales) | ≤ 30 min | 2,5 s | DBCC CHECKDB limpio, 352 filas contiguas |
billing (PostgreSQL) |
≤ 5 min | 2,5 min (2,5 s reales) | ≤ 60 min | 39,7 s | pg_amcheck limpio, 387 filas contiguas |
- Copias enviadas antes de T0:
appointments1 completa (528 KiB), 1 diferencial (196 KiB), 26 copias de log (828 KiB);billing1 copia base (4,2 MiB) y 389 archivos de WAL (388 segmentos más una etiqueta de copia, 8,9 MiB comprimidos). Cadenas de restauración usadas: completa + diferencial + las 3 copias de log posteriores; base + 386 segmentos de WAL contiguos (más el archivo de etiqueta de la copia). - El ataque: con la clave de copias robada, el ransomware hizo 3.184 intentos sobre las 796 versiones de objetos
originales. Los 796 intentos de acortar la retención y los 796 borrados de versión fueron rechazados
(
InvalidRequest: Object is WORM protected and cannot be overwritten); las 796 sobrescrituras y los 796 borrados simples se aceptaron, pero solo añadieron versiones nuevas y marcadores de borrado encima. 0 versiones originales perdidas. - Por qué el RPO es el que es: SQL Server perdió las filas escritas después de la última copia de log (minuto de política 390, el ataque en el 400): unos 10 minutos de política. PostgreSQL envía WAL cada minuto de política, así que perdió unos 2,5.
- Por qué los RTO son tan cortos: las bases son pequeñas (cientos de filas más 500 registros sintéticos cada una) y el bucket está en la misma red. Los minutos no se trasladan a producción; el método sí — RTO medido desde "recuperación declarada" hasta "restauración verificada".
- Tiempo en CI: el job
drilltarda 8–9 minutos (contenedores, un calendario de 400 minutos de política en unos 7 minutos, ataque, restauraciones en paralelo). - Imágenes: SQL Server
2025-CU9-ubuntu-24.04@sha256:2b5b5816…, PostgreSQL18.6-trixie@sha256:5a5a84b1…, MinIOchainguard/minio@sha256:0f95aa41…, mcchainguard/minio-client@sha256:231c5976….
Pull requests de demostración (cerrados sin fusionar; el ruleset bloquea la fusión):
| PR | Cambio | Qué pasó |
|---|---|---|
| #1 | bucket externo sin Object Lock | la clave robada borró las 799 versiones originales; no sobrevivió ningún manifiesto, así que ninguna base se pudo restaurar; la compuerta falló (drill), y unit falló en las pruebas que fijan el bloqueo en modo compliance |
| #2 | copias de log de SQL Server cada 60 minutos en lugar de 15 | 6 copias de log en lugar de 26, la última 40 minutos de política antes del ataque; ambas restauraciones se verificaron y no se perdió nada en el nivel externo, pero el RPO logrado fue 41,3 min frente a 15 y la compuerta falló (drill); unit falló en las pruebas que fijan la política y el calendario del repositorio |
8. Lecciones
- La herramienta que se pensaba leer cambió. En PostgreSQL 18,
pg_basebackup -vcon-X noneya no imprime el punto de inicio del WAL; el propiobackup_manifestde la copia lo registra (WAL-Ranges→Start-LSN), así que el simulacro lo lee de ahí. - Los archivos que escribe un servicio no los puede leer el siguiente. SQL Server escribe sus copias como
0660a nombre de su propio usuario y PostgreSQL archiva el WAL como0600; el proceso de envío en el host no podía leer ninguno. Cada copia se escribe en un archivo.part, se hace legible y luego se renombra, así el proceso de envío nunca ve un archivo a medio escribir o ilegible. - La imagen prevista puede desaparecer. MinIO ya no publica sus propias imágenes de contenedor comunitarias; el laboratorio usa una compilación mantenida (Chainguard) fijada por digest.
- Un bucle puede perder su entrada a manos de un proceso hijo. El primer simulacro hizo una sola copia y luego
esperó el ataque:
docker compose exec, ejecutado dentro de un buclewhile read, leyó el resto del calendario de la entrada estándar del bucle. Ahora cada paso recibe/dev/nullcomo entrada. - "Rechazado" y "mal formado" son respuestas distintas. El ataque intentó primero acortar la retención a ahora; MinIO responde a una fecha que no está en el futuro como una petición mal formada, no como un rechazo, y eso detuvo el script del ataque. Ahora el atacante pide un minuto desde ahora — un acortamiento real, que el bloqueo rechaza.
- Object Lock se comporta como está documentado, y vale la pena demostrarlo. Con una clave que puede borrar versiones, MinIO rechazó cada borrado de una versión bloqueada ("WORM protected and cannot be overwritten"); un borrado simple solo añadió un marcador de borrado encima del original intacto.
9. Límites
- Contenedores y datos sintéticos; bases pequeñas, así que los minutos absolutos de RTO no se trasladan a producción.
- Tiempo comprimido para el calendario de copias (el RPO se convierte de nuevo a minutos de política; el RTO no se comprime).
- MinIO hace las veces de almacenamiento inmutable en la nube (S3 Object Lock, blobs inmutables de Azure).
- El ejercicio de mesa es escrito, no se realizó con personas.
- No cubierto: gestión de claves de cifrado de copias, copias de máquinas virtuales y servidores de archivos, alta disponibilidad.
10. Reproducirlo
Haga un fork del repositorio y active Actions: cada push ejecuta el simulacro. En local (Linux, macOS o WSL con
Docker), siga el inicio rápido del README: bash scripts/run-drill.sh escribe out/report.html y
out/results.json.
11. Correspondencia
| Marco | Elementos |
|---|---|
| CIS Controls v8 | 11.1 proceso de recuperación de datos, 11.2 copias de seguridad automatizadas, 11.3 proteger los datos de recuperación, 11.4 instancia aislada de los datos de recuperación, 11.5 probar la recuperación de datos, 17.4 proceso de respuesta a incidentes |
| MITRE ATT&CK | T1486 Data Encrypted for Impact, T1490 Inhibit System Recovery (ataques a las copias), T1485 Data Destruction — lo que el simulacro reproduce y de lo que se recupera |